HW3 - Image Classifier
TensorFlow for Image Classification
For this assignment we’re going to train an ML algorithm to distinguish between pictures of cats and pictures of dogs.
Consider it a good first foray into a few vital subjects:
- TensorFlow pipeline syntax and structure
- Batching and prefetching data to prepare us to work with larger datasets
- Data augmentation to allow us to create expanded versions of our data sets that allow models to learn patterns more robustly.
- Transfer learning to allow us to use pre-trained models for new tasks.
So, without further delay, let’s get to our imports:
import os
import tensorflow as tf
from tensorflow.keras import utils
The Dataset
Now, let’s access the data. We’ll use a sample data set provided by the TensorFlow team that contains labeled images of cats and dogs.
The needed code:
# location of data
_URL = 'https://storage.googleapis.com/mledu-datasets/cats_and_dogs_filtered.zip'

# download the data and extract it
path_to_zip = utils.get_file('cats_and_dogs.zip', origin=_URL, extract=True)

# construct paths
PATH = os.path.join(os.path.dirname(path_to_zip), 'cats_and_dogs_filtered')

train_dir = os.path.join(PATH, 'train')
validation_dir = os.path.join(PATH, 'validation')

# parameters for datasets
BATCH_SIZE = 32
IMG_SIZE = (160, 160)

# construct train and validation datasets
train_dataset = utils.image_dataset_from_directory(train_dir,
                                                   shuffle=True,
                                                   batch_size=BATCH_SIZE,
                                                   image_size=IMG_SIZE)

validation_dataset = utils.image_dataset_from_directory(validation_dir,
                                                        shuffle=True,
                                                        batch_size=BATCH_SIZE,
                                                        image_size=IMG_SIZE)

# construct the test dataset by taking every 5th observation out of the validation dataset
val_batches = tf.data.experimental.cardinality(validation_dataset)
test_dataset = validation_dataset.take(val_batches // 5)
validation_dataset = validation_dataset.skip(val_batches // 5)
Downloading data from https://storage.googleapis.com/mledu-datasets/cats_and_dogs_filtered.zip
68608000/68606236 [==============================] - 0s 0us/step
68616192/68606236 [==============================] - 0s 0us/step
Found 2000 files belonging to 2 classes.
Found 1000 files belonging to 2 classes.
With the above code we have created TensorFlow Datasets for training, validation, and testing, which is vital when it’s not convienent or feasible to load all the data into memory.
A few key bits of syntax to know:
- The shuffle arg. makes it so that when data is pulled from this set, the order is randomized.
- The batch_size arg. sets how many datapoints are pulled from the set at a time
- The image_size arg. specifies the size of the images used, in this case, 160x160 pixels
Working with Datasets
Next we’ll write a function to create a two-row visualization. In the first row, show three random pictures of cats. In the second row, show three random pictures of dogs; it should provide a little practice working with datasets and batches while giving an idea of what the images we’re dealing with look like.
import matplotlib.pyplot as plt
import numpy as np
def twoRowVisual(dataset):

  #pull and store names of classes (image catagories)
  class_names = dataset.class_names
  plt.figure(figsize=(9, 6)) #set figure dims

  #if given a full dataset and not a batch, pull a batch
  if (type(dataset) != 'BatchDataset'):
    dataset = dataset.take(1)

  #iterate through pertinent portions of subset batch
  for images, labels in dataset:
    #some counters for loops...tensorflow doesn't bool index easy like pandas
    catcount = 0
    dogcount = 0
    #ugly loops, seriously, if the assignment didn't seem to want this function
    #to work soley w/ tf datasets, I'd convert the batch to a pd df or np array
    for i in range(len(labels)):
      if ( (catcount < 3) and (class_names[labels[i]] == 'cats') ):
        ax = plt.subplot(2, 3, catcount + 1)
        plt.imshow(images[i].numpy().astype("uint8"))
        plt.title(class_names[labels[i]])
        plt.axis("off")
        catcount += 1
      elif ( (dogcount < 3) and (class_names[labels[i]] == 'dogs') ):
        ax = plt.subplot(2, 3, dogcount + 4)
        plt.imshow(images[i].numpy().astype("uint8"))
        plt.title(class_names[labels[i]])
        plt.axis("off")
        dogcount +=1
      else:
        break
twoRowVisual(train_dataset)
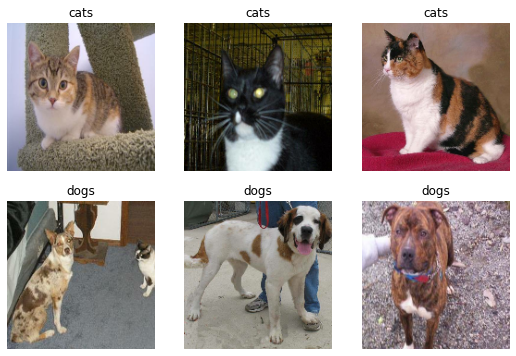
While I’m guessing you expected pictures of cats and dogs, it is worth noting how un-uniform these pictures are—bad lighting, different orientation of the subject, different relative size of the subject within the frame, etc.—which is what makes what’s about to come pretty cool
Next we’re going to set up our prefetching, which is a little dense to get into here, but is if you’re into it, is explained in more depth here
AUTOTUNE = tf.data.AUTOTUNE

train_dataset = train_dataset.prefetch(buffer_size=AUTOTUNE)
validation_dataset = validation_dataset.prefetch(buffer_size=AUTOTUNE)
test_dataset = test_dataset.prefetch(buffer_size=AUTOTUNE)
Check Label Frequencies
To get an idea of the baseline rate in our data set we next need to create an iterator by unbatching our data, mapping it, and casting it to a numpy iterator.From there we just follow normal for __ in __, automatic, container based iterative looping and count the labels.
#create iterator - unbatch and remap the prefetch dataset OBJ, conv to numpy itr
labels_iterator= train_dataset.unbatch().map(lambda image, label: label).as_numpy_iterator()

#create variable to store our baseline count
baseline = 0
count = 0

#iterate through
for label in labels_iterator:
  baseline += label
  count += 1

print(baseline)
print(count)
print(baseline / count)
1000
2000
0.5
So, our dataset is perfectly balanced between cats and dogs…lovely, I’d have been surprised if TensorFlow assembled it asymmetrically! That’s our baseline number to beat (50%).
First Model
Now let’s put together our first model….
(with a bonus diatribe to start)
 #if you perform this operation as the last line in a cell or as a print(), it
 #will display the shape info, but explicitly calling .shape on a BatchDataset
 #OBJ does not work as it does not have an attribute "shape"...It inherets from
 #datset, which has shape, and clearly the cell pulls such info...
print(train_dataset.take(1))

#a single element does the same
print(train_dataset.get_single_element)

#The moral? Do as much as you can before you import or convert to tf datasets.
#I'm literally only doing it this way as I don't know the specs of the import
#and the assignment wants me to do it this way. Organize data first, batches
#and prefetch will want you to remap back to a standard dataset to use most
#of the syntax you've gotten used to.
<TakeDataset element_spec=(TensorSpec(shape=(None, 160, 160, 3), dtype=tf.float32, name=None), TensorSpec(shape=(None,), dtype=tf.int32, name=None))>
<bound method DatasetV2.get_single_element of <PrefetchDataset element_spec=(TensorSpec(shape=(None, 160, 160, 3), dtype=tf.float32, name=None), TensorSpec(shape=(None,), dtype=tf.int32, name=None))>>
from tensorflow.keras import datasets, layers, models
Here we’ll actually arrange the layers within our model.
The Layers:
- Conv2d: creates a layer of convolutional kernels, in this case 3x3 pixels
- MaxPooling2d: downsamples the input by taking the max value over an input window (2x2 pixels in this case) - helps thin the herd both in terms of noise and computational efficiency
- Dropout: same as before, randomly drops datapoints to help with overfitting
- Flatten: flatten data from 2d to 1d for the dense layers to follow
- Dense: same as prior tutorials.
Our first attempt (model1) will be the bear minimum: Conv2D, MaxPooling2d, Flatten and Dense layers alone:
model1 = models.Sequential([
      layers.Conv2D(32, (3, 3), activation='relu', input_shape=(160, 160, 3)),
      layers.MaxPooling2D((2, 2)),
      layers.Conv2D(32, (3, 3), activation='relu'),
      layers.MaxPooling2D((2, 2)),
      layers.Conv2D(64, (3, 3), activation='relu'), # n "pixels" x n "pixels" x 64
      layers.Flatten(), # n^2 * 64 length vector

      layers.Dense(64, activation='relu'),
      layers.Dense(2) # number of classes in your dataset
])
model1.summary()
Model: "sequential"
_________________________________________________________________
 Layer (type)                Output Shape              Param #
=================================================================
 conv2d (Conv2D)             (None, 158, 158, 32)      896

 max_pooling2d (MaxPooling2D  (None, 79, 79, 32)       0
 )

 conv2d_1 (Conv2D)           (None, 77, 77, 32)        9248

 max_pooling2d_1 (MaxPooling  (None, 38, 38, 32)       0
 2D)

 conv2d_2 (Conv2D)           (None, 36, 36, 64)        18496

 flatten (Flatten)           (None, 82944)             0

 dense (Dense)               (None, 64)                5308480

 dense_1 (Dense)             (None, 2)                 130

=================================================================
Total params: 5,337,250
Trainable params: 5,337,250
Non-trainable params: 0
_________________________________________________________________
model1.compile(optimizer='adam',
              loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics = ['accuracy'])
%tensorflow_version 2.x
import tensorflow as tf
device_name = tf.test.gpu_device_name()
if device_name != '/device:GPU:0':
  raise SystemError('GPU device not found')
print('Found GPU at: {}'.format(device_name))
Found GPU at: /device:GPU:0
history = model1.fit(train_dataset,
                     epochs=20,
                     validation_data = validation_dataset)
Epoch 1/20
63/63 [==============================] - 16s 62ms/step - loss: 46.8510 - accuracy: 0.4950 - val_loss: 0.6912 - val_accuracy: 0.5272
Epoch 2/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6631 - accuracy: 0.6370 - val_loss: 0.7198 - val_accuracy: 0.5322
Epoch 3/20
63/63 [==============================] - 4s 58ms/step - loss: 0.5433 - accuracy: 0.7265 - val_loss: 0.7695 - val_accuracy: 0.5842
Epoch 4/20
63/63 [==============================] - 4s 57ms/step - loss: 0.3381 - accuracy: 0.8525 - val_loss: 0.9556 - val_accuracy: 0.5730
Epoch 5/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1784 - accuracy: 0.9360 - val_loss: 1.0043 - val_accuracy: 0.5879
Epoch 6/20
63/63 [==============================] - 5s 74ms/step - loss: 0.1308 - accuracy: 0.9590 - val_loss: 1.2579 - val_accuracy: 0.5582
Epoch 7/20
63/63 [==============================] - 4s 55ms/step - loss: 0.0999 - accuracy: 0.9725 - val_loss: 1.7968 - val_accuracy: 0.5941
Epoch 8/20
63/63 [==============================] - 4s 57ms/step - loss: 0.1023 - accuracy: 0.9705 - val_loss: 2.2078 - val_accuracy: 0.5916
Epoch 9/20
63/63 [==============================] - 4s 56ms/step - loss: 0.0696 - accuracy: 0.9775 - val_loss: 2.1428 - val_accuracy: 0.5903
Epoch 10/20
63/63 [==============================] - 4s 59ms/step - loss: 0.0376 - accuracy: 0.9895 - val_loss: 2.5053 - val_accuracy: 0.5842
Epoch 11/20
63/63 [==============================] - 4s 56ms/step - loss: 0.0685 - accuracy: 0.9835 - val_loss: 1.7227 - val_accuracy: 0.5953
Epoch 12/20
63/63 [==============================] - 4s 56ms/step - loss: 0.0615 - accuracy: 0.9820 - val_loss: 3.1237 - val_accuracy: 0.5743
Epoch 13/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0250 - accuracy: 0.9930 - val_loss: 2.6122 - val_accuracy: 0.5804
Epoch 14/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0090 - accuracy: 0.9980 - val_loss: 2.6767 - val_accuracy: 0.5842
Epoch 15/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0042 - accuracy: 0.9995 - val_loss: 3.4152 - val_accuracy: 0.5767
Epoch 16/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0119 - accuracy: 0.9970 - val_loss: 3.1464 - val_accuracy: 0.5668
Epoch 17/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0613 - accuracy: 0.9825 - val_loss: 2.1627 - val_accuracy: 0.5866
Epoch 18/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0359 - accuracy: 0.9925 - val_loss: 2.6074 - val_accuracy: 0.5854
Epoch 19/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0279 - accuracy: 0.9920 - val_loss: 2.5656 - val_accuracy: 0.5990
Epoch 20/20
63/63 [==============================] - 4s 57ms/step - loss: 0.0326 - accuracy: 0.9915 - val_loss: 2.2806 - val_accuracy: 0.6101
This first model stabilized between 60 and 61% accuracy. Not bad, but far from great. Let’s take another stab at, calling it model1_1 (model 1, 1st improvement? I named these before writing this, I dunno man). We’re also massively overfitting, the training set is scoring around 99% compared to 61% for the validation set. Let’s add a dropout layer to see if it helps:
model1_1 = models.Sequential([
      layers.Conv2D(32, (3, 3), activation='relu', input_shape=(160, 160, 3)),
      layers.MaxPooling2D((2, 2)),
      layers.Conv2D(32, (3, 3), activation='relu'),
      layers.MaxPooling2D((2, 2)),
      tf.keras.layers.Dropout(rate=0.2),
      layers.Conv2D(64, (3, 3), activation='relu'), # n "pixels" x n "pixels" x 64
      layers.Flatten(), # n^2 * 64 length vector

      layers.Dense(64, activation='relu'),
      layers.Dense(2) # number of classes in your dataset
])
model1_1.compile(optimizer='adam',
              loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics = ['accuracy'])
history1_1 = model1_1.fit(train_dataset,
                     epochs=20,
                     validation_data = validation_dataset)
Epoch 1/20
63/63 [==============================] - 4s 58ms/step - loss: 40.7283 - accuracy: 0.5275 - val_loss: 0.6939 - val_accuracy: 0.5111
Epoch 2/20
63/63 [==============================] - 4s 59ms/step - loss: 0.6744 - accuracy: 0.5860 - val_loss: 0.6967 - val_accuracy: 0.5260
Epoch 3/20
63/63 [==============================] - 4s 61ms/step - loss: 0.6391 - accuracy: 0.6080 - val_loss: 0.6995 - val_accuracy: 0.5446
Epoch 4/20
63/63 [==============================] - 4s 60ms/step - loss: 0.5970 - accuracy: 0.6650 - val_loss: 0.7250 - val_accuracy: 0.5334
Epoch 5/20
63/63 [==============================] - 4s 60ms/step - loss: 0.5531 - accuracy: 0.6870 - val_loss: 0.7280 - val_accuracy: 0.5656
Epoch 6/20
63/63 [==============================] - 4s 59ms/step - loss: 0.4849 - accuracy: 0.7410 - val_loss: 0.7905 - val_accuracy: 0.5941
Epoch 7/20
63/63 [==============================] - 4s 58ms/step - loss: 0.4361 - accuracy: 0.7835 - val_loss: 0.8108 - val_accuracy: 0.5854
Epoch 8/20
63/63 [==============================] - 4s 58ms/step - loss: 0.3692 - accuracy: 0.8270 - val_loss: 0.9603 - val_accuracy: 0.5755
Epoch 9/20
63/63 [==============================] - 4s 60ms/step - loss: 0.3338 - accuracy: 0.8475 - val_loss: 1.0265 - val_accuracy: 0.5879
Epoch 10/20
63/63 [==============================] - 4s 59ms/step - loss: 0.3234 - accuracy: 0.8555 - val_loss: 1.1079 - val_accuracy: 0.5693
Epoch 11/20
63/63 [==============================] - 4s 59ms/step - loss: 0.2424 - accuracy: 0.8920 - val_loss: 1.2843 - val_accuracy: 0.5829
Epoch 12/20
63/63 [==============================] - 4s 58ms/step - loss: 0.1832 - accuracy: 0.9185 - val_loss: 1.5899 - val_accuracy: 0.5978
Epoch 13/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1641 - accuracy: 0.9300 - val_loss: 1.5651 - val_accuracy: 0.6200
Epoch 14/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1559 - accuracy: 0.9375 - val_loss: 1.4159 - val_accuracy: 0.6015
Epoch 15/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1056 - accuracy: 0.9585 - val_loss: 1.9492 - val_accuracy: 0.6213
Epoch 16/20
63/63 [==============================] - 4s 56ms/step - loss: 0.1022 - accuracy: 0.9635 - val_loss: 2.1940 - val_accuracy: 0.5953
Epoch 17/20
63/63 [==============================] - 4s 56ms/step - loss: 0.1020 - accuracy: 0.9595 - val_loss: 1.8305 - val_accuracy: 0.6176
Epoch 18/20
63/63 [==============================] - 4s 57ms/step - loss: 0.1144 - accuracy: 0.9535 - val_loss: 2.1844 - val_accuracy: 0.6064
Epoch 19/20
63/63 [==============================] - 4s 56ms/step - loss: 0.1066 - accuracy: 0.9595 - val_loss: 2.0984 - val_accuracy: 0.5990
Epoch 20/20
63/63 [==============================] - 4s 55ms/step - loss: 0.0682 - accuracy: 0.9785 - val_loss: 2.3234 - val_accuracy: 0.5928
V1.1 - Not much better, falling between 59 and 61% accuracy. and still severely overfitting Let’s try another arragement of layers with even more dropouts:
model1_2 = models.Sequential([
      layers.Conv2D(32, (3, 3), activation='relu', input_shape=(160, 160, 3)),
      layers.MaxPooling2D((2, 2)),
      tf.keras.layers.Dropout(rate=0.2),
      layers.Conv2D(32, (3, 3), activation='relu'),
      layers.MaxPooling2D((2, 2)),
      tf.keras.layers.Dropout(rate=0.2),
      layers.Conv2D(64, (3, 3), activation='relu'), # n "pixels" x n "pixels" x 64
      layers.Flatten(), # n^2 * 64 length vector
      tf.keras.layers.Dropout(rate=0.2),

      layers.Dense(64, activation='relu'),
      tf.keras.layers.Dropout(rate=0.2),
      layers.Dense(2) # number of classes in your dataset
])
model1_2.compile(optimizer='adam',
              loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics = ['accuracy'])
history1_2 = model1_2.fit(train_dataset,
                     epochs=20,
                     validation_data = validation_dataset)
Epoch 1/20
63/63 [==============================] - 4s 59ms/step - loss: 58.9596 - accuracy: 0.5060 - val_loss: 0.6882 - val_accuracy: 0.5186
Epoch 2/20
63/63 [==============================] - 4s 55ms/step - loss: 0.6983 - accuracy: 0.5250 - val_loss: 0.6903 - val_accuracy: 0.5062
Epoch 3/20
63/63 [==============================] - 4s 55ms/step - loss: 0.6927 - accuracy: 0.5175 - val_loss: 0.6972 - val_accuracy: 0.4926
Epoch 4/20
63/63 [==============================] - 6s 88ms/step - loss: 0.6849 - accuracy: 0.5425 - val_loss: 0.6962 - val_accuracy: 0.5631
Epoch 5/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6643 - accuracy: 0.5815 - val_loss: 0.6991 - val_accuracy: 0.5483
Epoch 6/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6584 - accuracy: 0.5825 - val_loss: 0.7136 - val_accuracy: 0.5408
Epoch 7/20
63/63 [==============================] - 4s 55ms/step - loss: 0.6280 - accuracy: 0.6130 - val_loss: 0.7902 - val_accuracy: 0.5322
Epoch 8/20
63/63 [==============================] - 4s 55ms/step - loss: 0.6041 - accuracy: 0.6425 - val_loss: 0.7504 - val_accuracy: 0.5755
Epoch 9/20
63/63 [==============================] - 4s 63ms/step - loss: 0.5674 - accuracy: 0.6790 - val_loss: 0.7707 - val_accuracy: 0.5829
Epoch 10/20
63/63 [==============================] - 5s 75ms/step - loss: 0.5492 - accuracy: 0.6930 - val_loss: 0.9423 - val_accuracy: 0.5767
Epoch 11/20
63/63 [==============================] - 5s 82ms/step - loss: 0.5248 - accuracy: 0.7195 - val_loss: 0.8501 - val_accuracy: 0.5718
Epoch 12/20
63/63 [==============================] - 6s 85ms/step - loss: 0.4989 - accuracy: 0.7305 - val_loss: 0.9044 - val_accuracy: 0.5730
Epoch 13/20
63/63 [==============================] - 5s 70ms/step - loss: 0.4605 - accuracy: 0.7610 - val_loss: 0.9045 - val_accuracy: 0.5891
Epoch 14/20
63/63 [==============================] - 4s 57ms/step - loss: 0.4372 - accuracy: 0.7745 - val_loss: 1.0750 - val_accuracy: 0.6027
Epoch 15/20
63/63 [==============================] - 4s 63ms/step - loss: 0.4110 - accuracy: 0.7890 - val_loss: 1.2232 - val_accuracy: 0.6101
Epoch 16/20
63/63 [==============================] - 5s 71ms/step - loss: 0.3640 - accuracy: 0.8300 - val_loss: 1.3792 - val_accuracy: 0.6312
Epoch 17/20
63/63 [==============================] - 5s 75ms/step - loss: 0.3479 - accuracy: 0.8330 - val_loss: 1.3543 - val_accuracy: 0.6064
Epoch 18/20
63/63 [==============================] - 5s 78ms/step - loss: 0.3122 - accuracy: 0.8505 - val_loss: 1.4907 - val_accuracy: 0.6275
Epoch 19/20
63/63 [==============================] - 4s 56ms/step - loss: 0.3131 - accuracy: 0.8625 - val_loss: 1.2664 - val_accuracy: 0.6374
Epoch 20/20
63/63 [==============================] - 4s 56ms/step - loss: 0.2920 - accuracy: 0.8740 - val_loss: 1.1579 - val_accuracy: 0.6399
There we go! V1.2 stabilized between 63 and 64% accuracy yet still experienced overfitting (the training set scored significantly higher than the validation set) however to a significantly lesser degree.
Model with Data Augmentation
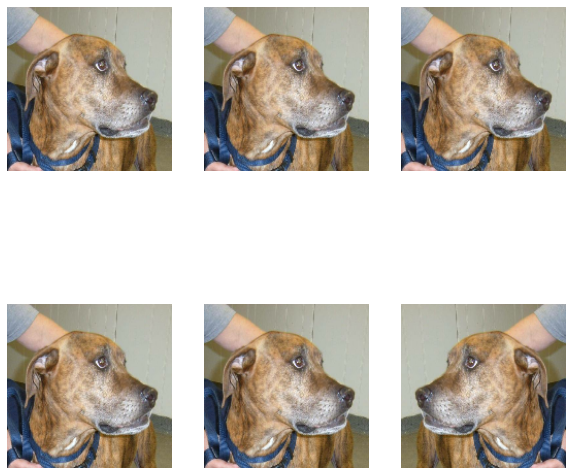
For our second model, we’re going to add data augmentation layers, which, by including modified copies of the same images in the set, will help our model learn invariant features of our images.
We’re going to add an image flipping and an image rotating layer. Just to see what that looks like:
flip_example = tf.keras.layers.RandomFlip('horizontal')

for image, _ in train_dataset.take(1):
  plt.figure(figsize=(10, 10))
  first_image = image[0]
  for i in range(6):
    ax = plt.subplot(2, 3, i + 1)
    augmented_image = flip_example(tf.expand_dims(first_image, 0))
    plt.imshow(augmented_image[0] / 255)
    plt.axis('off')
Now let’s add these two layers to the model and test it:
model2 = models.Sequential([
      tf.keras.layers.RandomFlip(),
      tf.keras.layers.RandomRotation(factor = 0.2),
      layers.Conv2D(32, (3, 3), activation='relu', input_shape=(160, 160, 3)),
      layers.MaxPooling2D((2, 2)),
      #tf.keras.layers.Dropout(rate=0.2),
      layers.Conv2D(32, (3, 3), activation='relu'),
      layers.MaxPooling2D((2, 2)),
      #tf.keras.layers.Dropout(rate=0.2),
      layers.Conv2D(64, (3, 3), activation='relu'), # n "pixels" x n "pixels" x 64
      layers.Flatten(), # n^2 * 64 length vector
      #tf.keras.layers.Dropout(rate=0.2),

      layers.Dense(64, activation='relu'),
      #tf.keras.layers.Dropout(rate=0.2),
      layers.Dense(2) # number of classes in your dataset
])
model2.compile(optimizer='adam',
              loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics = ['accuracy'])
history2 = model2.fit(train_dataset,
                     epochs=20,
                     validation_data = validation_dataset)
Epoch 1/20
63/63 [==============================] - 5s 61ms/step - loss: 27.7780 - accuracy: 0.5415 - val_loss: 0.7245 - val_accuracy: 0.5495
Epoch 2/20
63/63 [==============================] - 5s 73ms/step - loss: 0.6988 - accuracy: 0.5675 - val_loss: 0.7080 - val_accuracy: 0.5483
Epoch 3/20
63/63 [==============================] - 4s 60ms/step - loss: 0.6765 - accuracy: 0.5960 - val_loss: 0.6789 - val_accuracy: 0.5829
Epoch 4/20
63/63 [==============================] - 4s 61ms/step - loss: 0.6766 - accuracy: 0.6110 - val_loss: 0.6624 - val_accuracy: 0.6101
Epoch 5/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6649 - accuracy: 0.6160 - val_loss: 0.6793 - val_accuracy: 0.5854
Epoch 6/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6715 - accuracy: 0.6065 - val_loss: 0.6739 - val_accuracy: 0.6064
Epoch 7/20
63/63 [==============================] - 4s 55ms/step - loss: 0.6542 - accuracy: 0.6220 - val_loss: 0.6684 - val_accuracy: 0.6040
Epoch 8/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6439 - accuracy: 0.6425 - val_loss: 0.6614 - val_accuracy: 0.6374
Epoch 9/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6346 - accuracy: 0.6455 - val_loss: 0.6699 - val_accuracy: 0.6287
Epoch 10/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6390 - accuracy: 0.6430 - val_loss: 0.6718 - val_accuracy: 0.6126
Epoch 11/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6451 - accuracy: 0.6435 - val_loss: 0.6997 - val_accuracy: 0.5606
Epoch 12/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6314 - accuracy: 0.6405 - val_loss: 0.6919 - val_accuracy: 0.6027
Epoch 13/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6406 - accuracy: 0.6510 - val_loss: 0.6549 - val_accuracy: 0.6163
Epoch 14/20
63/63 [==============================] - 4s 58ms/step - loss: 0.6317 - accuracy: 0.6580 - val_loss: 0.7084 - val_accuracy: 0.6052
Epoch 15/20
63/63 [==============================] - 4s 58ms/step - loss: 0.6327 - accuracy: 0.6555 - val_loss: 0.6559 - val_accuracy: 0.6163
Epoch 16/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6226 - accuracy: 0.6635 - val_loss: 0.6773 - val_accuracy: 0.6188
Epoch 17/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6369 - accuracy: 0.6410 - val_loss: 0.6832 - val_accuracy: 0.6386
Epoch 18/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6220 - accuracy: 0.6535 - val_loss: 0.6585 - val_accuracy: 0.6312
Epoch 19/20
63/63 [==============================] - 4s 57ms/step - loss: 0.6215 - accuracy: 0.6615 - val_loss: 0.6593 - val_accuracy: 0.6399
Epoch 20/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6239 - accuracy: 0.6515 - val_loss: 0.6532 - val_accuracy: 0.6386
So, it appears that while this model stored about the same as the prior (between 63 and 64% validation accuracy) it did so with no apparent overfitting; the test set actually performed slightly worse than the validation set. If you look at what I’ve commented out, you’ll also notice that this was achieved without dropout layers…those actually docked the performance of this model down to roughly chance, perhaps on account of dropping the image that the Data Augmentation layers made a modified copy of, thus confusing the whole thing.
Data Preprocessing
Next we’re going to incorporate a preprocessing layer. This will normalize our RGB values between 0 and 1, making our model significantly more computationally efficient.
#i = tf.keras.Input(shape=(160, 160, 3))
x = tf.keras.applications.mobilenet_v2.preprocess_input(i)
preprocessor = tf.keras.Model(inputs = [i], outputs = [x])
model3 = models.Sequential([
      preprocessor,
      tf.keras.layers.RandomFlip(),
      tf.keras.layers.RandomRotation(factor = 0.4),
      layers.Conv2D(32, (3, 3), activation='relu', input_shape=(160, 160, 3)),
      layers.MaxPooling2D((2, 2)),
      layers.Conv2D(32, (3, 3), activation='relu'),
      layers.MaxPooling2D((2, 2)),
      tf.keras.layers.Dropout(rate=0.2),
      layers.Conv2D(64, (3, 3), activation='relu'), # n "pixels" x n "pixels" x 64
      layers.Flatten(), # n^2 * 64 length vector

      layers.Dense(64, activation='relu'),
      layers.Dense(2) # number of classes in your dataset
])
model3.compile(optimizer='adam',
              loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics = ['accuracy'])
history3 = model3.fit(train_dataset,
                     epochs=20,
                     validation_data = validation_dataset)
Epoch 1/20
63/63 [==============================] - 5s 58ms/step - loss: 0.7626 - accuracy: 0.5215 - val_loss: 0.6771 - val_accuracy: 0.5829
Epoch 2/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6637 - accuracy: 0.5750 - val_loss: 0.6873 - val_accuracy: 0.5681
Epoch 3/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6532 - accuracy: 0.6085 - val_loss: 0.6455 - val_accuracy: 0.6522
Epoch 4/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6370 - accuracy: 0.6030 - val_loss: 0.6483 - val_accuracy: 0.5804
Epoch 5/20
63/63 [==============================] - 4s 55ms/step - loss: 0.6482 - accuracy: 0.6000 - val_loss: 0.6640 - val_accuracy: 0.5891
Epoch 6/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6233 - accuracy: 0.6395 - val_loss: 0.6352 - val_accuracy: 0.6361
Epoch 7/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6121 - accuracy: 0.6790 - val_loss: 0.6051 - val_accuracy: 0.6795
Epoch 8/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6169 - accuracy: 0.6435 - val_loss: 0.6254 - val_accuracy: 0.6411
Epoch 9/20
63/63 [==============================] - 4s 56ms/step - loss: 0.6041 - accuracy: 0.6725 - val_loss: 0.5932 - val_accuracy: 0.7017
Epoch 10/20
63/63 [==============================] - 4s 55ms/step - loss: 0.5991 - accuracy: 0.6805 - val_loss: 0.6152 - val_accuracy: 0.6906
Epoch 11/20
63/63 [==============================] - 4s 56ms/step - loss: 0.5713 - accuracy: 0.6990 - val_loss: 0.6056 - val_accuracy: 0.6745
Epoch 12/20
63/63 [==============================] - 4s 56ms/step - loss: 0.5726 - accuracy: 0.6970 - val_loss: 0.5879 - val_accuracy: 0.6906
Epoch 13/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5565 - accuracy: 0.7125 - val_loss: 0.5874 - val_accuracy: 0.6770
Epoch 14/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5503 - accuracy: 0.7170 - val_loss: 0.5888 - val_accuracy: 0.6683
Epoch 15/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5544 - accuracy: 0.7185 - val_loss: 0.5841 - val_accuracy: 0.7129
Epoch 16/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5477 - accuracy: 0.7210 - val_loss: 0.5754 - val_accuracy: 0.6856
Epoch 17/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5488 - accuracy: 0.7005 - val_loss: 0.5592 - val_accuracy: 0.6980
Epoch 18/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5370 - accuracy: 0.7160 - val_loss: 0.5765 - val_accuracy: 0.7092
Epoch 19/20
63/63 [==============================] - 4s 57ms/step - loss: 0.5366 - accuracy: 0.7380 - val_loss: 0.5737 - val_accuracy: 0.7240
Epoch 20/20
63/63 [==============================] - 4s 56ms/step - loss: 0.5291 - accuracy: 0.7300 - val_loss: 0.5744 - val_accuracy: 0.7042
Awesome, this performance increase resulting in a validation score that stabilizes accross runs between 70 and 72% with little signs of overfitting based on the relative performance between train and validation sets.
Transfer Learning
For our last model, we’re going to incorporate a pre-trained model as the base. Lets first download the model:
IMG_SHAPE = IMG_SIZE + (3,)
base_model = tf.keras.applications.MobileNetV2(input_shape=IMG_SHAPE,
                                               include_top=False,
                                               weights='imagenet')
base_model.trainable = False

i = tf.keras.Input(shape=IMG_SHAPE)
x = base_model(i, training = False)
base_model_layer = tf.keras.Model(inputs = [i], outputs = [x])
Downloading data from https://storage.googleapis.com/tensorflow/keras-applications/mobilenet_v2/mobilenet_v2_weights_tf_dim_ordering_tf_kernels_1.0_160_no_top.h5
9412608/9406464 [==============================] - 0s 0us/step
9420800/9406464 [==============================] - 0s 0us/step
Next we’ll slot in this base model as a layer between our data augmentation layers and our subsequent pooling, dropout, and final, classifying dense layer.
model4 = models.Sequential([
      preprocessor,
      tf.keras.layers.RandomFlip('horizontal'),
      tf.keras.layers.RandomRotation(factor = 0.3),
      base_model_layer,
      tf.keras.layers.GlobalAveragePooling2D(),
      tf.keras.layers.Dropout(rate=0.2),
      layers.Dense(1)
])
model4.compile(optimizer='adam',
              loss = tf.keras.losses.BinaryCrossentropy(from_logits=True),
              metrics = ['accuracy'])
history4 = model4.fit(train_dataset,
                     epochs=20,
                     validation_data = validation_dataset)
Epoch 1/20
63/63 [==============================] - 10s 96ms/step - loss: 0.4044 - accuracy: 0.7940 - val_loss: 0.1286 - val_accuracy: 0.9579
Epoch 2/20
63/63 [==============================] - 4s 61ms/step - loss: 0.2284 - accuracy: 0.9040 - val_loss: 0.0933 - val_accuracy: 0.9666
Epoch 3/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1855 - accuracy: 0.9190 - val_loss: 0.0651 - val_accuracy: 0.9802
Epoch 4/20
63/63 [==============================] - 4s 59ms/step - loss: 0.1682 - accuracy: 0.9245 - val_loss: 0.0618 - val_accuracy: 0.9765
Epoch 5/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1666 - accuracy: 0.9300 - val_loss: 0.0544 - val_accuracy: 0.9827
Epoch 6/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1585 - accuracy: 0.9310 - val_loss: 0.0553 - val_accuracy: 0.9740
Epoch 7/20
63/63 [==============================] - 4s 59ms/step - loss: 0.1516 - accuracy: 0.9325 - val_loss: 0.0487 - val_accuracy: 0.9876
Epoch 8/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1426 - accuracy: 0.9390 - val_loss: 0.0545 - val_accuracy: 0.9839
Epoch 9/20
63/63 [==============================] - 4s 59ms/step - loss: 0.1400 - accuracy: 0.9420 - val_loss: 0.0497 - val_accuracy: 0.9851
Epoch 10/20
63/63 [==============================] - 4s 59ms/step - loss: 0.1462 - accuracy: 0.9390 - val_loss: 0.0453 - val_accuracy: 0.9827
Epoch 11/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1260 - accuracy: 0.9500 - val_loss: 0.0544 - val_accuracy: 0.9765
Epoch 12/20
63/63 [==============================] - 4s 61ms/step - loss: 0.1454 - accuracy: 0.9375 - val_loss: 0.0478 - val_accuracy: 0.9864
Epoch 13/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1401 - accuracy: 0.9400 - val_loss: 0.0524 - val_accuracy: 0.9740
Epoch 14/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1317 - accuracy: 0.9470 - val_loss: 0.0439 - val_accuracy: 0.9814
Epoch 15/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1296 - accuracy: 0.9490 - val_loss: 0.0506 - val_accuracy: 0.9839
Epoch 16/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1425 - accuracy: 0.9415 - val_loss: 0.0531 - val_accuracy: 0.9802
Epoch 17/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1289 - accuracy: 0.9485 - val_loss: 0.0462 - val_accuracy: 0.9802
Epoch 18/20
63/63 [==============================] - 4s 61ms/step - loss: 0.1271 - accuracy: 0.9465 - val_loss: 0.0460 - val_accuracy: 0.9765
Epoch 19/20
63/63 [==============================] - 4s 62ms/step - loss: 0.1370 - accuracy: 0.9430 - val_loss: 0.0510 - val_accuracy: 0.9777
Epoch 20/20
63/63 [==============================] - 4s 60ms/step - loss: 0.1074 - accuracy: 0.9530 - val_loss: 0.0408 - val_accuracy: 0.9876
This last model stabilized between 98 and 99% accuracy! with no signs of overfitting as the test set scored worse than the validation set. Moral of the story? Work smart, not hard. Stand on the shoulders of giants. Am I missing any truisms about this concept? You get the idea.
#Scoring on Test Data
Lastly, let’s take this final combined model and evaluate it using unseen test data:
# Retrieve a batch of images from the test set
image_batch, label_batch = test_dataset.as_numpy_iterator().next()
predictions = model4.predict_on_batch(image_batch).flatten()
print(predictions.shape)
print(model4.predict_on_batch(image_batch).shape)

# Apply a sigmoid since our model returns logits
predictions = tf.nn.sigmoid(predictions)
predictions = tf.where(predictions < 0.5, 0, 1)

print('Predictions:\n', predictions.numpy())
print('Labels:\n', label_batch)
print(np.mean(predictions.numpy() == label_batch))
(32,)
(32, 1)
Predictions:
 [0 0 1 1 0 1 0 1 0 1 1 0 0 1 0 1 0 0 0 0 1 0 1 1 0 1 1 1 0 1 0 1]
Labels:
 [0 0 1 1 0 1 0 1 0 1 1 0 0 1 0 1 0 0 0 0 1 0 1 1 0 1 1 1 0 1 0 1]
1.0
Nice, we scored 100% on our test batch!